© 2026 武汉见山行科技有限公司 版权所有 鄂ICP备2025109496号-1鄂公网安备42018502007933号
Skip to content
返回应用详情
MOSS-Transcribe-Diarize
支持 50+ 语言长音频的文字转写、说话人区分与精准时间戳标注
注意:请在客户端中打开,如果没有客户端,前往下载 >>>
应用特点
支持语言
系统要求
建议16GB以上内存。硬盘空间11GB以上。
macOS 15及以上版本,支持Intel和M系列芯片。
Windows 10/11,可用Intel, AMD CPU,NVIDIA GPU。
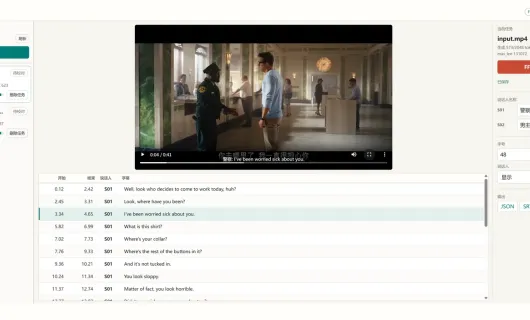
注意:NVIDIA显卡,请安装较新版本的驱动。截图预览
应用介绍
开发团队与背景
MOSS-Transcribe-Diarize 是由复旦大学 OpenMOSS 团队开源的下一代语音理解大模型。
核心功能与产品特点
- 转写 + 角色区分一站式搞定:上传一段多人说话的音频,它不仅能把语音转换成文字,还能自动识别“是谁在说话”(自动标记为
[S01]、[S02]等说话人)。 - 精准时间戳:自动标注每一句话的开始和结束时间,方便直接生成字幕或定位音频位置。
- 环境音与声学事件识别:不仅能听懂话,还能识别背景中的笑声、掌声、咳嗽声等声学事件。
- 超长音频与多语言支持:支持单次处理长达 90 分钟的超长音频,并覆盖超过 50 种语言。
典型应用场景
- 会议纪要整理:自动识别多方讨论,快速输出带说话人标识的会议记录。
- 采访与播客转写:将对话录音直接转化为排版清晰的对谈文稿。
- 视频字幕制作:为长视频一键生成带精准时间轨的字幕文件。
- 课堂与讲座记录:高效整理长时讲座,提取文字内容。
底层技术原理
- 端到端(End-to-End)语音大模型:传统方案通常采用“语音识别(ASR)+ 说话人分割(Diarization)”的多个独立模型拼装;而该项目采用 0.9B(约 9 亿参数) 的单体多模态语音大模型,在一次推理(Single Pass)中同时完成文本生成、说话人识别与时间戳预测。
- 轻量化与高效率:模型参数体量小(仅 0.9B),在保持高准确率的同时,显著降低了显存占用和计算门槛,非常适合本地和轻量化部署。
许可证Apache-2.0